ChatGPT、Claude Code、GeminiなどのAIツールやAIエージェントに、データ入力、調査、開発、監査を任せられる場面が増えている。ところが、作業が終わるたびに「どの確認が効いたのか」「なぜ手戻りが起きたのか」「次回は何を省けるのか」が会話の中に埋もれてしまう。
そこで、実作業の中で得た気づきや失敗を記録し、次回の手順に反映する仕組みを作った。本記事では、この仕組みを改善研究ループと呼ぶ。AIが改善テーマと概算コストを先に提示し、人が選んだテーマ、または人が明示的にAIへ選定を任せたテーマだけを調べることで、依頼された作業を止めずに改善を続けられる。
中心にある問いは一つだ。AIエージェントの実作業を止めずに、そこで得た知見を次回へどう反映するか。以下では、仕組みを作った理由、設計、今後確かめる指標を順に紹介する。
この記事はこんな人向け
- AIエージェントにデータ入力、調査、開発、監査を任せている
- 作業中の気づきや失敗が、会話の中に埋もれている
- 品質を落とさず、確認作業とトークン消費を抑えたい
- AIの改善提案を、人が選べる形で運用したい
AIに作業と研究を同時に頼むと起きる4つの問題
「作業しながら、効率化も研究してほしい」という依頼は合理的に見える。しかし、研究の範囲を決めずに始めると、次の問題が起きやすい。
- 依頼された作業が後回しになる:改善のための画面確認や比較に時間を使い、入力・開発・監査が進まなくなる。
- 効果を測らないまま「改善できた」と判断してしまう:「速くなった気がする」という感覚と、ログや件数で確認した事実が混ざる。
- 検証テーマの幅が狭くなる:目の前の小さな改善だけに偏ったり、反対に実行できないほど大きな構想へ飛んだりする。
- 調査にかかるコストが膨らむ:トークン数、ツールの実行回数、待ち時間、確認作業の量を把握しないまま調査を続けてしまう。
必要だったのは、AIへ漠然と「もっと考えて」と頼むことではない。何を調べるか、どこまで掘り下げるか、何を根拠に判断するかを先に決められる仕組みだった。
依頼された作業と改善活動を分けて進める
改善研究ループでは、ユーザーから依頼された作業と、その過程から改善点を集める活動を分ける。改善活動は実作業の横で補助的に進める。主役はあくまで依頼された作業であり、改善活動を理由に権限や作業範囲を広げることはしない。
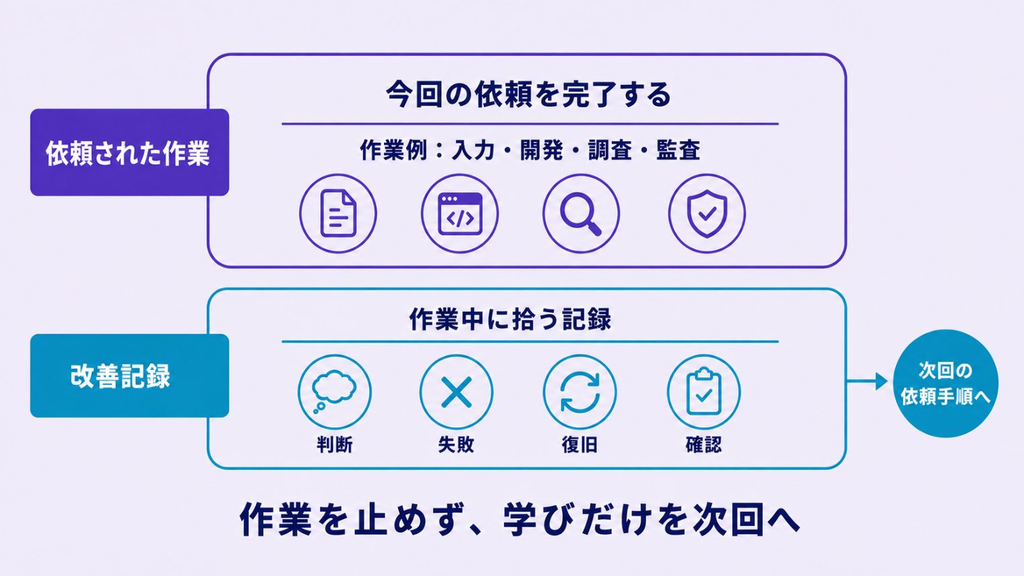
記録と検証の詳しさは、作業の規模やリスクに応じて3段階から選べるようにした。
| モード | 用途 | 記録するもの |
|---|---|---|
| Lean(最小限) | 速度とトークン消費を抑えたい通常作業 | 重要な判断、失敗、復旧手順、確認済みの件数 |
| Standard(標準) | 複数の工程を持つ作業 | 計画と実績、採用・不採用の理由、再利用できる結論 |
| Deep(詳細) | 長期・高リスク、または調査自体が成果物になる作業 | 役割分担、別担当による監査、検証に使ったログ・資料・判断記録一式 |
毎回Deepを選べば詳しい記録は残る。ただし、改善の記録に時間をかけすぎると、依頼された作業を圧迫してしまう。通常はLeanから始め、リスクや不明点が大きいときだけ詳しく調べる。
研究を始める前に、テーマとコストを一覧化する
次に、改善テーマの選定をAI任せにしないための候補一覧を加えた。テーマが指定されていない場合は、細かな検証から定石にとらわれない仮説まで、方向の異なる候補を4〜6件提示する。
以下の負荷と推定トークンは、今回の運用を始めるために仮置きした区分である。実績が蓄積した段階で見直す。
| ID | 研究テーマ例 | 種類 | 重要度 | 負荷 | 推定トークン |
|---|---|---|---|---|---|
| R1 | 「保存しました」という画面表示だけで、データが実際に保存されたと判断してよいか | 精密検証 | 高 | 軽 | S:2k〜5k |
| R2 | 一覧で対象を絞ってから詳細を開くと、画面の読み取り回数は減るか | 実務改善 | 高 | 中 | M:5k〜12k |
| R3 | すべて入力した後にまとめて確認する方法と、入力と並行して順次確認する方法では、どちらがミスを防ぎやすいか | 仕組み | 中 | 中 | M:5k〜12k |
| R4 | あえて一画面・一対象に制限すると、異常にも早く気づけるか | 探索的仮説 | 中 | 軽 | S:2k〜5k |
候補を出す段階では、時間のかかる調査には着手しない。ユーザーは候補から選ぶだけでよく、必要なら複数のテーマを組み合わせたり、選定そのものをAIへ明示的に任せたりできる。もちろん、今回は改善研究を行わないという選択も残す。
調査そのものが目的なら、テーマが選ばれてから着手する。実作業と並行する場合は、作業を進めながら判断理由や失敗内容だけを記録し、選ばれていない調査は始めない。
トークン数は「実績」ではなく「計画値」として扱う
AI運用では、トークン数を細かく見せるほど正確に見える。しかし、モデル、ツール出力、ファイルサイズ、会話履歴によって消費量は変わる。計測機能がない環境で「3,842トークン使う」と断定しても根拠がない。
そこで、改善活動を追加したことで増えるトークンだけを、次の幅で見積もる。
XSはおよそ2k以下、Sは2k〜5k、Mは5k〜12k、Lは12k〜25k、XLは25k超とする。
これはあくまで推定範囲であり、依頼された作業そのものに使うトークンは含めない。また、トークン数が同程度でも、ブラウザの待ち時間や複数担当者との調整が必要なら負担は大きい。そのため、候補一覧では「推定トークン」と「作業負荷」を分けている。
実際のトークン数を取得できる場合も、見積もりは消さず「推定」と「実績」を両方残す。直接計測できない場合は、詳細画面を開いた回数、ツールの実行回数、比較した資料数などを代わりの目安として記録する。
「確認した事実」と「もっともらしい推測」を分ける
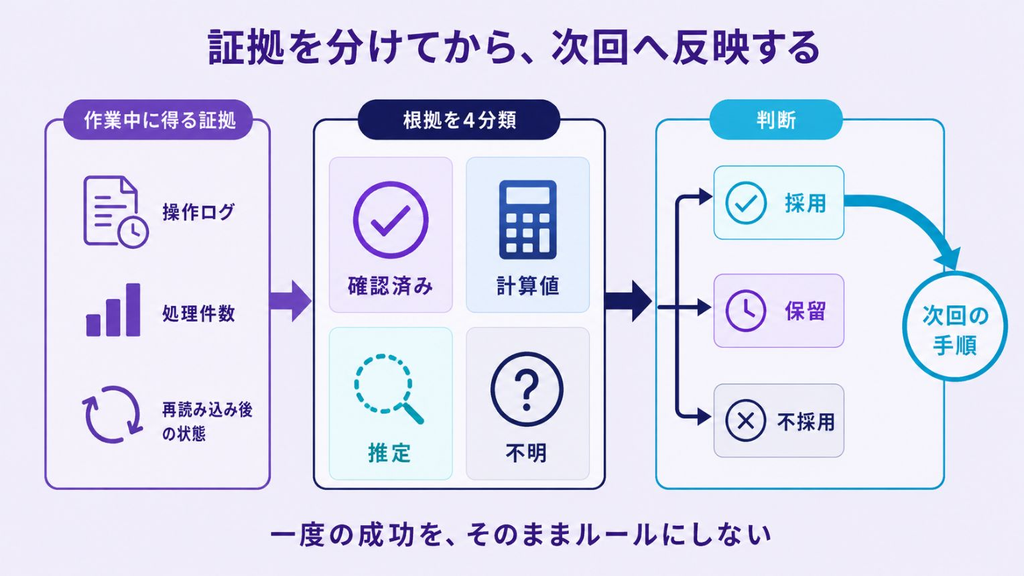
研究記録は、次の4段階で根拠を分類する。
- 確認済み:操作ログ、処理件数、ファイル内容の変化を示すハッシュ値、再読み込み後のデータなどで直接確かめた。
- 計算値:実際に取得した数値を基に計算した。計算式や比較基準を示せる。
- 推定:筋の通った説明はできるが、まだ比較実験はしていない。
- 不明:必要な計測がない、または情報源が信頼できない。
たとえば「一覧画面で対象を絞ったので速くなった」は、比較するまでは推定にすぎない。実際の効果を確かめるには、従来の手順と新しい手順で画面の読み取り回数や所要時間を比べる必要がある。一度うまくいった方法を、すべての作業に通用するルールだと決めつけないようにする。
実際にハマったところ:保存表示だけでは確認にならない
この記事を作る過程でも、アイキャッチ画像のタイトルと代替テキストは更新されていたのに、プレビューには古い画像が表示された。そこで画像ファイルそのものを開いて違いを確認し、正しい画像をアップロードし直した。保存後は編集画面を再読み込みし、プレビューの表示まで見直した。「設定値が変わった」で終わらせず、読者に見える結果まで確かめた例である。
実装は、スキル・詳細ルール・記録スクリプトを分離する
AIが毎回参照する SKILL.md には、作業方針を決める最小限のルールだけを置いた。詳しい進め方や記録用テンプレートは別ファイルに分け、必要なときだけ参照する。
Gemini、Claude Code、Codexでは、設定ファイルや機能の呼び出し方が異なる。そのため、特定製品の設定をそのまま使い回すのではなく、「依頼された作業を優先する」「改善テーマを選ぶ」「確認できた事実と推測を分ける」「知見を次回の手順へ戻す」という共通部分を分離しておく。
work-research-loop/
├── SKILL.md
├── agents/
│   └── openai.yaml
├── references/
│   ├── method.md
│   ├── report-spec.md
│   └── research-theme-menu.md
└── scripts/
    └── research_ledger.py
記録スクリプトは、作業開始時の条件、途中で起きたこと、計測結果、最終的に得た知見を決まった形式で保存する。同じ記録を再実行しても重複しないようIDを持たせている。複数のAIによる競合を防ぐため、運用上は改善記録を保存する担当を一つに限定し、ほかのAIは読み取りと確認だけを担当する。
運用で外せない5つのルール
- 研究は権限を広げない:改善案を考えることと、データ更新・送信・公開の許可は別である。
- 同じデータを更新するAIは一つに絞る:並行して作業する場合は、担当するデータを完全に分ける。監査担当は読み取り専用にする。
- 保存完了のメッセージだけで判断しない:画面を再読み込みし、入力したデータが実際に残っていることまで確認する。
- 改善記録に機密情報を残さない:非公開リポジトリであっても、顧客名、認証情報、元資料へのURL、加工していない操作ログは保存しない。
- 提案と実行を分ける:定石にとらわれない案も候補には含めるが、選ばれていない実験は始めない。
従来の進め方との違い
| 従来の進め方 | 改善研究ループを使う場合 |
|---|---|
| 作業中の気づきが会話の中に埋もれる | 判断理由・失敗内容・復旧手順を決まった形式で残す |
| AIが調査範囲を暗黙に決める | 候補と概算コストを見て人が選ぶ |
| 「速くなった気がする」で終わる | 確認済み・計算値・推定・不明を分ける |
| 複数のAIが同じデータを更新して競合する | 更新担当を一つに絞り、別のAIが読み取り専用で確認する |
| 同じ失敗を繰り返し調べ直す | 失敗の原因と復旧手順を、確認結果とともに次回へ引き継ぐ |
ただし、現時点で「トークンを何%削減できた」「作業時間が何分短くなった」とまでは言えない。仕組みを作ったことと、効果を測ったことは別だからだ。
まとめ
AIエージェントの仕事を継続的に改善するには、高性能なモデルへ置き換えるだけでは足りない。実作業で得た知見を、権限・根拠・コストの扱いを決めたうえで、次回の手順へ反映する必要がある。
この仕組みの要点は、依頼された作業を優先しながら、改善テーマと概算コストを人が選べる形で提示することだ。人が明示的に任せた場合だけAIがテーマを選ぶ。検証では確認できた事実と推測を分け、失敗の原因や復旧手順まで次回へ引き継ぐ。
AIに「もっと考えて」と頼むのではなく、何を調べるか、どれだけのトークンや時間を使うか、どの方法で確認するかを選べるようにする。こうすることで、AIの使い方を実務の結果から継続的に改善できるようになる。