AIコーディングCLI(コマンドラインで動かすAIコーディングツール)を同じ課題で動かし、合格率や処理時間を比べる。数字を出すこと自体は難しくありません。難しいのは、その数字が本当に元の実行結果を表していると確認することです。
この記事が答える問いは、「AIコーディングCLIを比較するとき、非公開テストの漏洩、偽の合格、失敗の分母落ち、出所不明のCSVをどう防ぐか」です。
この記事では、次の4条件を満たす比較を「安全に結果を使える比較」とします。非公開テストが評価対象から見えない。候補コードが出した文字列を採点結果と誤認しない。失敗を含む全試行が残る。公開した集計を元の実行記録までたどれる。このどれかを確認できなければ、順位は出しません。
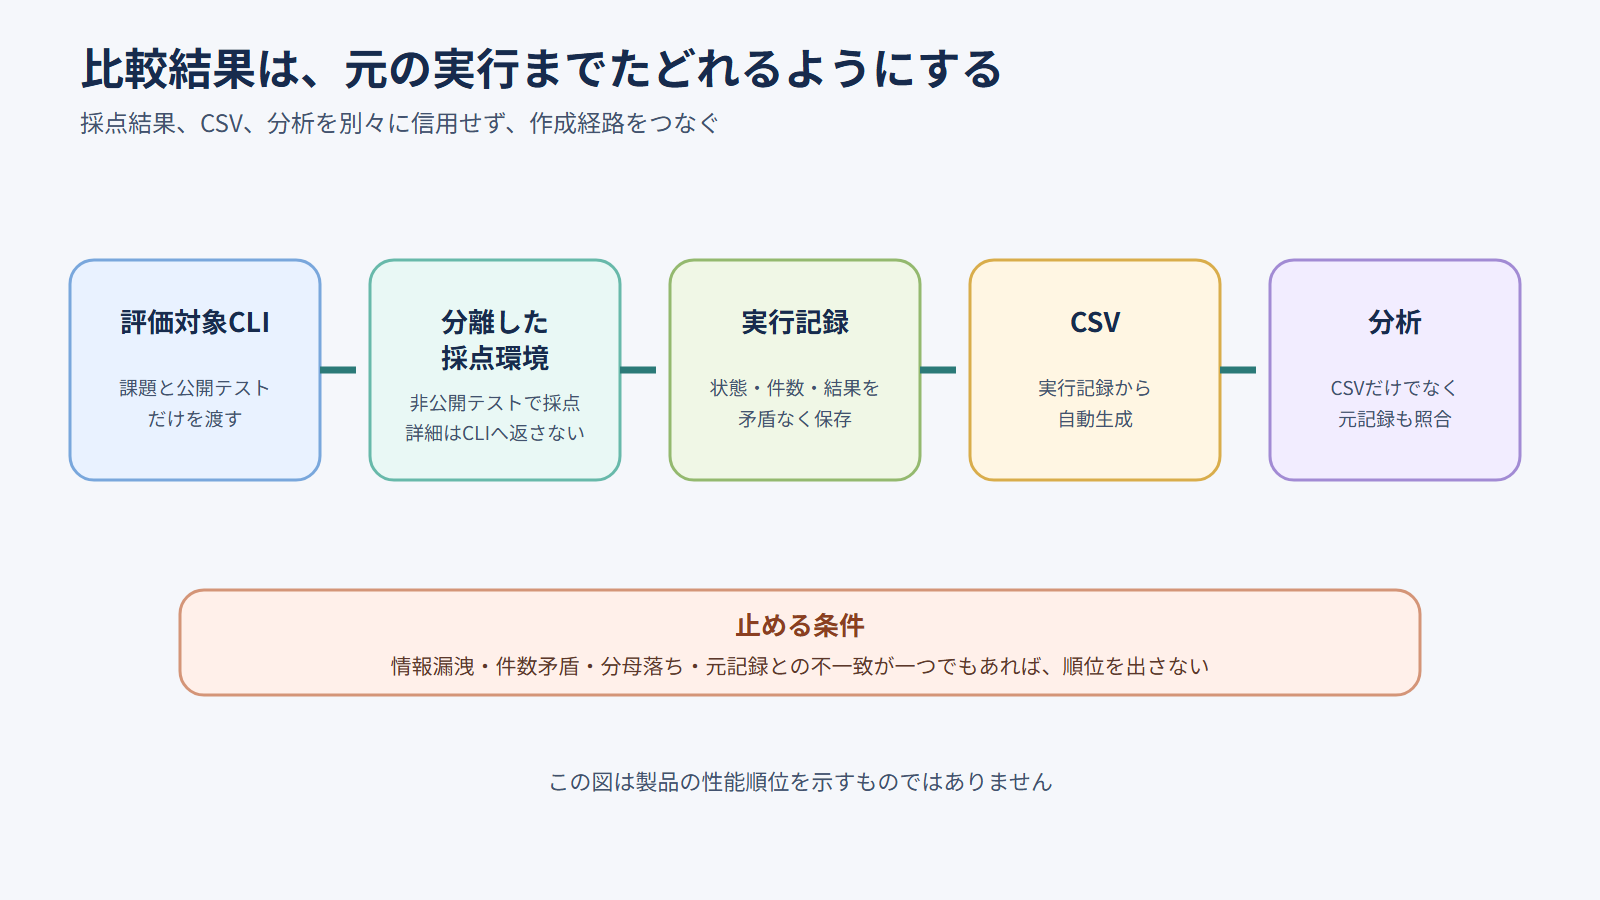
結論は四つです。非公開テストの詳細を評価対象CLIへ返さない。候補コードと採点器の出力を分ける。タイムアウトや採点不能を分母から消さない。CSVを元の実行記録から作り直せるようにする。この四つが確認できるまで、製品の順位は出しません。
この記事はこんな人向け
- Codex、Claude Code、Copilot CLIなどを同じ課題で比較したい
- AIコーディングツールの社内評価を作っている
- 非公開テストを置けば安全だと思っている
- タイムアウトを除いた合格率に違和感がある
- CSVやレポートを第三者が再確認できる形で残したい
ベンチマークが壊れる4つの場所
1. 非公開テストは標準出力からも漏れる
非公開テストを作業ディレクトリへ置かなくても、採点器が失敗したテスト名、期待値、確認式の断片を標準出力へ流せば、評価対象CLIへ情報が戻ります。再試行できる仕組みでは、1回目の失敗が2回目の答え合わせになります。
公開Issueでも、前段の検証結果や非公開扱いのデータが次のエージェントから見える問題が報告されています。「非公開」という名前や配置だけでは、実際に見えないことを保証できません。
対策は、ファイルと出力の両方を分けることです。
- 評価対象CLIへ渡すのは、課題、開始時のコード、公開テストだけにする
- 候補コードを確定してCLIを終了した後、分離した採点環境で非公開テストを使う
- 同じ試行のCLIへ、合否や非公開テストの詳細を返さない
- 再試行する場合は、別の非公開テストを使うか、新しい試行として分母に数える
- 詳細な期待値や採点ログは、CLIから見えない監査用の場所へ保存する
- 標準出力、標準エラー、環境変数、引数、作業ファイルの全経路を目印文字列で確認する
2. 候補コードと採点器を同じ場所で動かすと偽合格を見抜けない
候補コードと採点器を同じプロセスで動かすと、どちらが出した結果か分からなくなる危険があります。候補コードが次のような採点結果らしい文字列を出しても、見た目だけでは本物と区別できません。
{"passed":6,"total":6,"score":1}
また、採点処理を呼び出せたことを示す終了コード0と、課題に合格したことを混同すると、不合格まで成功に見えます。
対策は、候補コードの実行と採点を分け、採点器が作った結果だけを管理側から受け取ることです。そのうえで、課題ID、問題数、合格数、点数、各テスト結果の件数を照合します。passed=6、total=6なのに結果が1件しかなければ、合格ではなく採点結果の不正として止めます。
3. タイムアウトを除くと、失敗の多いCLIが有利になる
合格率を「合格数 ÷ 正常に終わった実行数」だけで計算すると、タイムアウト、異常終了、権限停止、採点不能を分母から落とせます。半分止まるCLIでも、完走した回だけを見れば強く見えてしまいます。
運用時の成績では、実行前に割り当てた最初の試行を分母へ残します。
| 実行 | 状態 | 運用時の成績 | 外部障害を除く参考成績 |
|---|---|---|---|
| A-1 | 合格 | 1 | 1 |
| A-2 | タイムアウト | 0 | 0 |
| A-3 | 採点基盤の障害 | 0 | 除外 |
| A-4 | 一部だけ完了 | 0 | 0 |
この例では、運用時の分母は4、外部障害を除く参考値の分母は3です。どちらか一方が常に正しいのではなく、答える問いが違います。後から都合のよい方だけを見せないため、両方の定義を実行前に決めます。
4. CSVを再計算できても、出所は証明できない
CSVから合格率を再計算して同じ数字になっても、CSVの行が本当に元の実行から作られたとは限りません。行を手で追加しても、そのCSVだけを再計算する処理では見抜けません。
必要なのは、次の流れをたどれることです。
実行 → 採点 → 実行記録 → CSV → 分析
CSVは保存済みの実行記録から自動生成します。検証時も保存済みCSVだけを読み直すのではなく、元の実行記録からCSVを作り直し、分析結果まで一致するか確認します。
元記録の信頼起点には、集計を確定した時点の実行記録を読み取り専用で複製した「確定スナップショット」を使う方法が、最も再現しやすいでしょう。
- 実行前の割当一覧に、課題IDと割り当てた試行数を記録する。
- 各試行の終了後、合格、不合格、タイムアウト、異常終了、採点不能の状態を元記録へ残す。
- 集計を確定する時点で、元記録を読み取り専用の場所へ複製する。
- 割当一覧と確定スナップショットの課題ID、割当試行数、状態別件数を照合する。
- 照合に通った確定スナップショットからCSVを再生成し、公開する集計と比べる。
読み取り専用スナップショットを作りにくい環境では、既存行を変更せず訂正も新しい行として追加する台帳を使います。別の保管先へ複製する場合は、ファイル内容から計算する改ざん検知用の照合値(例:SHA-256)を併記する方法もあります。ただし、照合値だけでは「どの実行から作られたか」は証明できないため、課題ID、割当試行数、状態との照合も必要です。
実際に見つかった3つの欠陥と修正
模擬データを使った自己テストの後、別担当の確認で三つの欠陥が見つかりました。
一つ目は、実行がタイムアウトした状態と、採点できなかった状態を同じ項目で扱っていたことです。このままでは、分母へ残すべき失敗を集計前に失う可能性がありました。修正後は、実行状態と採点状態を別々に保存し、矛盾する組み合わせを拒否します。
二つ目は、実行ごとにコピーした評価条件一覧だけを確認し、基準となる一覧と同じ内容かを確かめていなかったことです。修正後は、実行記録が参照する評価条件と、変更されない基準版の対応を確認します。
三つ目は、検証処理が保存済みCSVから分析を再計算するだけで、元の実行記録からCSVを作り直していなかったことです。修正後は、元記録を読み、CSVを再生成してから分析結果まで照合します。
同じ欠陥が再発しない試験を追加し、模擬データを改変した場合に処理が停止することを再確認しました。ただし、確認したのは比較基盤の整合性です。実際のAIモデルの性能順位を確認したわけではありません。
本番前に行う4つの小さな確認
漏洩の確認
非公開テストへHIDDEN-CANARY-1234のような目印を入れ、意図的に失敗する候補コードを採点します。評価対象CLIから見えるファイル、標準出力、標準エラー、環境変数、引数のどこにも目印が出ないことを確認します。
偽合格の確認
候補コードに、合格したように見えるJSONと終了コード0を出させます。採点器の結果として受理されず、不正な採点結果として止まることを確認します。
分母の確認
合格、タイムアウト、採点基盤の障害、一部完了の4行を用意します。運用時の成績では4行すべてが分母に残り、外部障害を除く参考値だけが3行になることを確認します。
CSVの出所確認
実行前に課題IDと割当試行数を記録し、実行後の状態を含む元記録から、集計確定時の読み取り専用スナップショットを作ります。課題ID、割当試行数、状態別件数を照合してからCSVを再生成します。
確認試験では、スナップショットの課題ID、件数、状態のいずれか一つを変更します。検証処理が保存済みCSVを信用せず、不一致を検出して止まることを確認します。
結果を使ってよいか判断する表
| 観測した状態 | 判定 | 次の行動 |
|---|---|---|
| 非公開情報がCLIの出力や環境から見える | 使用しない | 課題を廃棄し、未露出の課題でやり直す |
| 候補コードと採点器の出力を区別できない | 使用しない | 実行環境と採点経路を分ける |
| 問題数、合格数、点数、結果件数が矛盾する | 採点不能 | 合否を付けず、原因を調べる |
| タイムアウトを分母から落としている | 再集計 | 最初の試行を分母へ戻す |
| CSVはあるが元の実行記録へ戻れない | 未確認 | 順位を出さず、参考値として扱う |
| 元記録からCSVと分析を作り直せる | 次へ進める候補 | 別担当の確認と限界確認へ進む |
今回確認できた範囲
今回確認したのは、模擬データを使った比較基盤です。非公開テストの出力漏洩、偽合格、状態の矛盾、分母落ち、CSVの出所不明を、異常な入力で拒否できるかを試しました。
実際のCodex、Claude Code、Copilot CLIを使った比較実行は行っていません。そのため、製品の順位、実際の合格率、速度、費用はこの記事から判断できません。
また、採点環境を論理的に分けても、OSレベルの隔離まで自動的に証明できるわけではありません。実運用では、コンテナや仮想マシン、ファイル権限、ネットワーク、プロセスの見え方を別に確認する必要があります。
同じ課題を複数回実行したときの統計処理も重要ですが、この記事では深掘りしません。反復回数の扱いと信頼区間は、別の記事で扱う候補とします。
参考資料
まとめ
AIコーディングCLIを比較するときは、最後の合格率だけを見ても結果を信用できません。
非公開テストの情報を戻さない。候補コードと採点器の出力を分ける。タイムアウトや採点不能を分母から消さない。CSVを元の実行記録から作り直す。この四つを確認して初めて、製品を比べる準備が整います。