同じAIモデルを選んだのに、Codexでは修正まで進み、別のAI CLI(コマンドライン型のAI開発支援ツール)では途中で迷う。そんな差は、モデル名だけを見ても原因を切り分けられません。
この記事が答える問いは、「同じAIモデルを選んだのにAI CLIで結果が違うとき、何をどの順番で確認すればよいか」です。
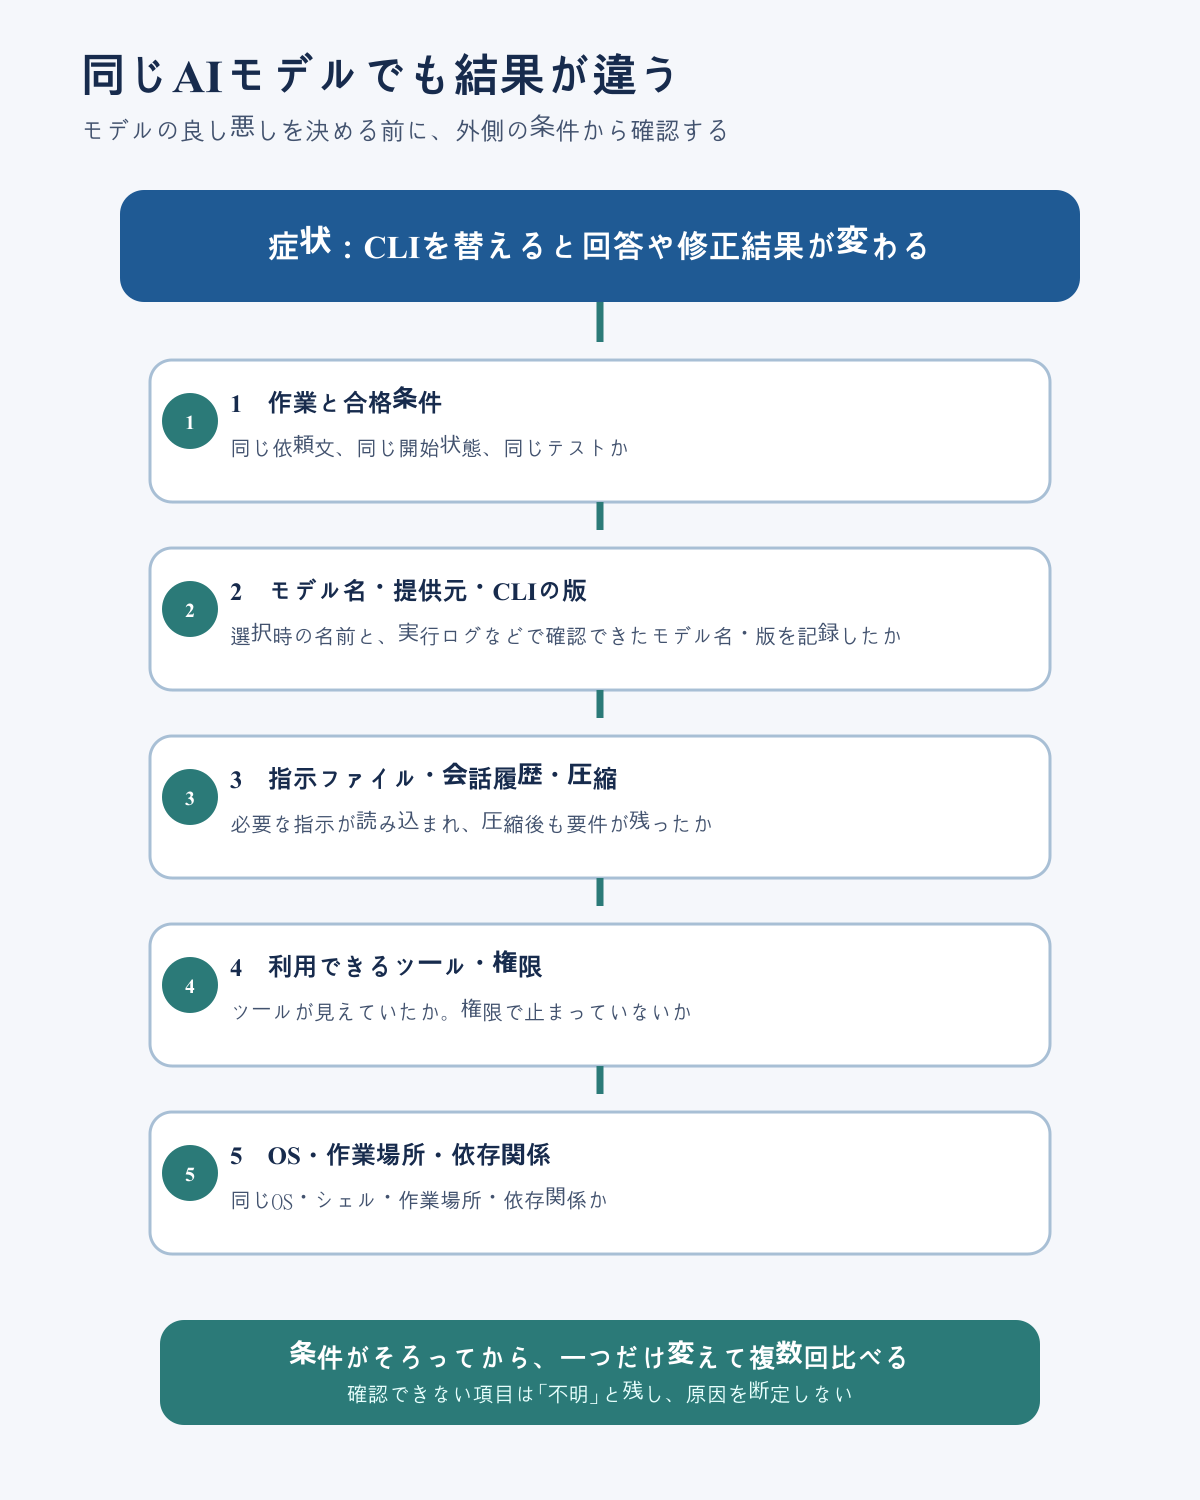
先に結論を言うと、作業条件、モデルと版、指示と会話履歴、ツールと権限、実行環境の順に確認します。それらがそろって初めて、一つの条件だけを変えた比較へ進みます。
この記事はこんな人向け
- CopilotでGPT系モデルを選んだ結果と、Codexの結果が違って困っている
- Claude CodeやCodexを替えたら、指示の守られ方やツールの使い方が変わった
- 「モデルが悪い」と決める前に、設定や環境の差を調べたい
- 比較結果をチームで再確認できる形に残したい
なぜ同じモデル名でも結果が変わるのか
AI CLIは、依頼文をモデルへ渡すだけの箱ではありません。指示ファイルを探し、利用できるツールをモデルへ示し、ファイルやコマンドの結果を会話履歴へ戻し、権限を確認します。長い会話を圧縮したり、別のエージェントへ一部の作業を任せたりする製品もあります。
そのため、同じモデル名でも次の条件が違えば、取れる行動が変わります。
- 実際に使われたモデルの版と提供元
- システム指示、リポジトリの指示、追加したスキル
- モデルから見えたツールと、その実行結果
- 新しい会話か、再開した会話か、圧縮後の会話か
- ファイル、ネットワーク、コマンドの権限
- OS、シェル、作業ディレクトリ、依存関係
つまり、比較するのはモデル単体ではなく、モデルを含む実行条件一式です。
症状ごとに最初の確認場所を変える
| 観測した症状 | 最初に確認すること | ここでは断定しないこと |
|---|---|---|
| 同じモデル名なのに回答が違う | モデルの提供元、確認できる版、推論設定(考える量) | 表示名だけでモデル本体の差と決めない |
| 指示を無視した | 読み込まれた指示ファイル、会話の圧縮、再開状態 | 実行時の指示が不明なら、モデルの性格と決めない |
| 必要なツールを使わない | その時点で見えていたツール、MCP(AIから外部ツールへ接続する仕組み)の接続状態、権限 | ツールが見えていなければ、選択ミスと決めない |
| 長い作業で急に迷う | 圧縮の発生、大きな出力、再開の有無 | 圧縮を確認できなければ、忘れたと決めない |
| ファイルを読めない・書けない | 権限、除外設定、組織の方針 | 権限拒否を能力不足と扱わない |
| Windowsだけ失敗する | シェル、パス、文字コード、依存関係 | OS条件をそろえる前に製品全体の差へ広げない |
原因を切り分ける6つの手順
1. 作業と合格条件を固定する
依頼文だけでなく、開始時のコミット、未保存の変更、依存関係、テスト、制限時間、ネットワーク条件をそろえます。開始状態や採点方法が違うなら、同じ課題の比較ではありません。
2. モデル名とCLIの版を分けて記録する
選択時の名前、実行ログなどで確認できたモデル名・版、提供元、CLIの版を別々に残します。
製品画面や設定に表示された名前だけでは、実際に使われた版を確定できない場合があります。確認方法がない項目は「不明」とします。
3. 指示と会話履歴を確認する
システム指示、ユーザーの依頼、AGENTS.mdやCLAUDE.mdなどのリポジトリ指示を分けます。どのファイルが読み込まれたか、会話を再開したか、途中で圧縮されたかも記録します。
4. 見えていたツールと権限を確認する
モデルは、存在を知らないツールを選べません。ツール一覧、MCPの接続、実行エラー、承認待ち、ファイルとネットワークの権限を確認します。
5. OSと作業環境をそろえる
対話実行、非対話実行、IDE(統合開発環境)、デスクトップ、クラウドでは処理の流れが異なる場合があります。OS、シェル、作業ディレクトリ、依存関係まで含めて同じ条件かを確かめます。
6. 一つだけ変えて複数回比べる
ここまでの条件を固定し、モデル、CLI、指示、ツールのうち一つだけを変えます。実行順を入れ替え、事前に決めた回数だけ繰り返します。1回の勝敗だけで順位を作りません。
実際にハマりやすい4つの点
表示名を正確なモデル版だと思う
表示名や別名が指す先は、時期や提供元で変わる可能性があります。変更されない識別情報を取れなければ、「同じモデルの比較」とは言わず、「異なるAI CLIの比較」として扱います。
最終回答だけを保存する
最終回答だけでは、ツールが見えなかったのか、権限で止まったのか、会話の圧縮で条件を落としたのか分かりません。ツール履歴、エラー、終了理由も残します。
失敗した実行を再試行で消す
タイムアウト、利用制限、権限停止も実際の使い勝手の一部です。再試行する場合は元の失敗を残し、別の実行として記録します。
同じ提供元のCLI(ネイティブ製品)が常に勝つと決める
モデルとCLIを同じ提供元が調整できることは有利に働く可能性があります。しかし、常に勝つとは限りません。SWE-agentの研究でも、同じ基盤モデルでも操作方法や見せる情報で成績が変わり、情報を多く見せれば必ず改善するわけではないことが示されています。
チームで残す記録
比較1回ごとに、少なくとも次を残します。
| 項目 | 記録する内容 |
|---|---|
| 課題 | 依頼文、対象リポジトリ、開始コミット、合格条件 |
| 製品 | AI CLI名、版、実行方法 |
| モデル | 選択時の名前、実行ログなどで確認できたモデル名・版、提供元。不明なら理由 |
| 指示 | 読み込まれた指示ファイル、追加したスキル |
| 会話 | 新規・再開・分岐、圧縮の有無 |
| ツール | 見えていたツール、接続状態、エラー |
| 権限 | ファイル、ネットワーク、コマンドの許可と拒否 |
| 結果 | 変更内容、テスト、所要時間、停止理由 |
今回確認できた範囲
公開仕様と研究から、モデルの外側にある指示、ツール、会話履歴、権限、実行環境が結果へ影響し得ることは確認できます。
一方、今回の記事ではCodex、Claude Code、Copilot CLIを同じ課題・同じ条件で比較実験していません。どの製品が高性能か、どの条件が今回の体験差を生んだかは不明です。
この記事で示したのは順位ではなく、原因を調べる順番です。情報を取得できない段階では結論の範囲を狭めてください。
参考資料
- GitHub Copilot CLI:Auto model selection
- OpenAI Codex:configuration
- OpenAI Codex:AGENTS.md
- Claude Code:model configuration
- Claude Code:context window
- SWE-agent:Agent-Computer Interfaces Enable Automated Software Engineering
まとめ
同じAIモデルを選んでも、AI CLIが違えば、指示、ツール、会話履歴、権限、実行環境が変わります。
作業条件から順に確認し、分からない項目は「不明」と残します。条件がそろった後で一つだけ変えて複数回比べると、「モデルが悪い」という感想を、再確認できる原因候補へ変えられます。