はじめに
作業チケットには「ルーティングを直す」と書いていた。
でも手を動かしはじめてすぐ気づいた。自分がいま触っているのは、少なくとも 8 種類くらいの違う「ルーティング」だった。Cloudflare、さくらのクラウドの VM 上の nginx、WebAccel、オブジェクトストレージ、AppRun、SPA のルーター、backend API、そしてアプリ内の認可。全部が「どこへ流すか」を判断していて、しかも判断材料がそれぞれ違う。
同じ言葉で呼んでいたせいで、「これは LB でやるべきか、アプリでやるべきか」という議論が毎回ふりだしに戻っていた。
この記事では、ルーティングを一枚岩で考えるのをやめて、レイヤーごとに責務を切ったら設計も実装も検証も一気に楽になった、という話を書く。コードの詳細より、責務分担と検証観点が中心。
想定読者はこのあたり。
- Cloudflare を前段に置いてアプリを公開している人
- さくらのクラウド / WebAccel / AppRun / オブジェクトストレージを使っている人
- 既存アプリを段階的にモダン化している人
- SPA と backend API のルーティングでハマったことがある人
- 「これは LB でやるべき?アプリでやるべき?」と迷ったことがある人
背景
さくらのクラウド上で動いている既存の Web アプリを、Cloudflare 経由で公開していた。構成は伏せずに書きたいので、ホスト名とパスは実在のものから置き換えている。
既存の経路はシンプルで、フロントとバックエンドが別ホストに分かれている。
app.example.jp
  -> Sakura WebAccel
  -> Sakura Object Storage
  -> static frontend

api.example.jp
  -> Sakura WebAccel
  -> Sakura AppRun
  -> PHP backend
  -> 外部 LLM API
ここに、一部のパスだけ新しい経路を差し込むことになった。VM 上に nginx の edge router を立てて、/v2/ 配下だけをローカルのリリースに向け、それ以外は既存の WebAccel にそのまま流す。
User
  ↓
Cloudflare
  ↓
Sakura Cloud VM / nginx edge router
  ├─ /v2/       -> local sealed release
  └─ otherwise  -> existing Sakura WebAccel
                     ↓
                   Object Storage / AppRun
                     ↓
                   Application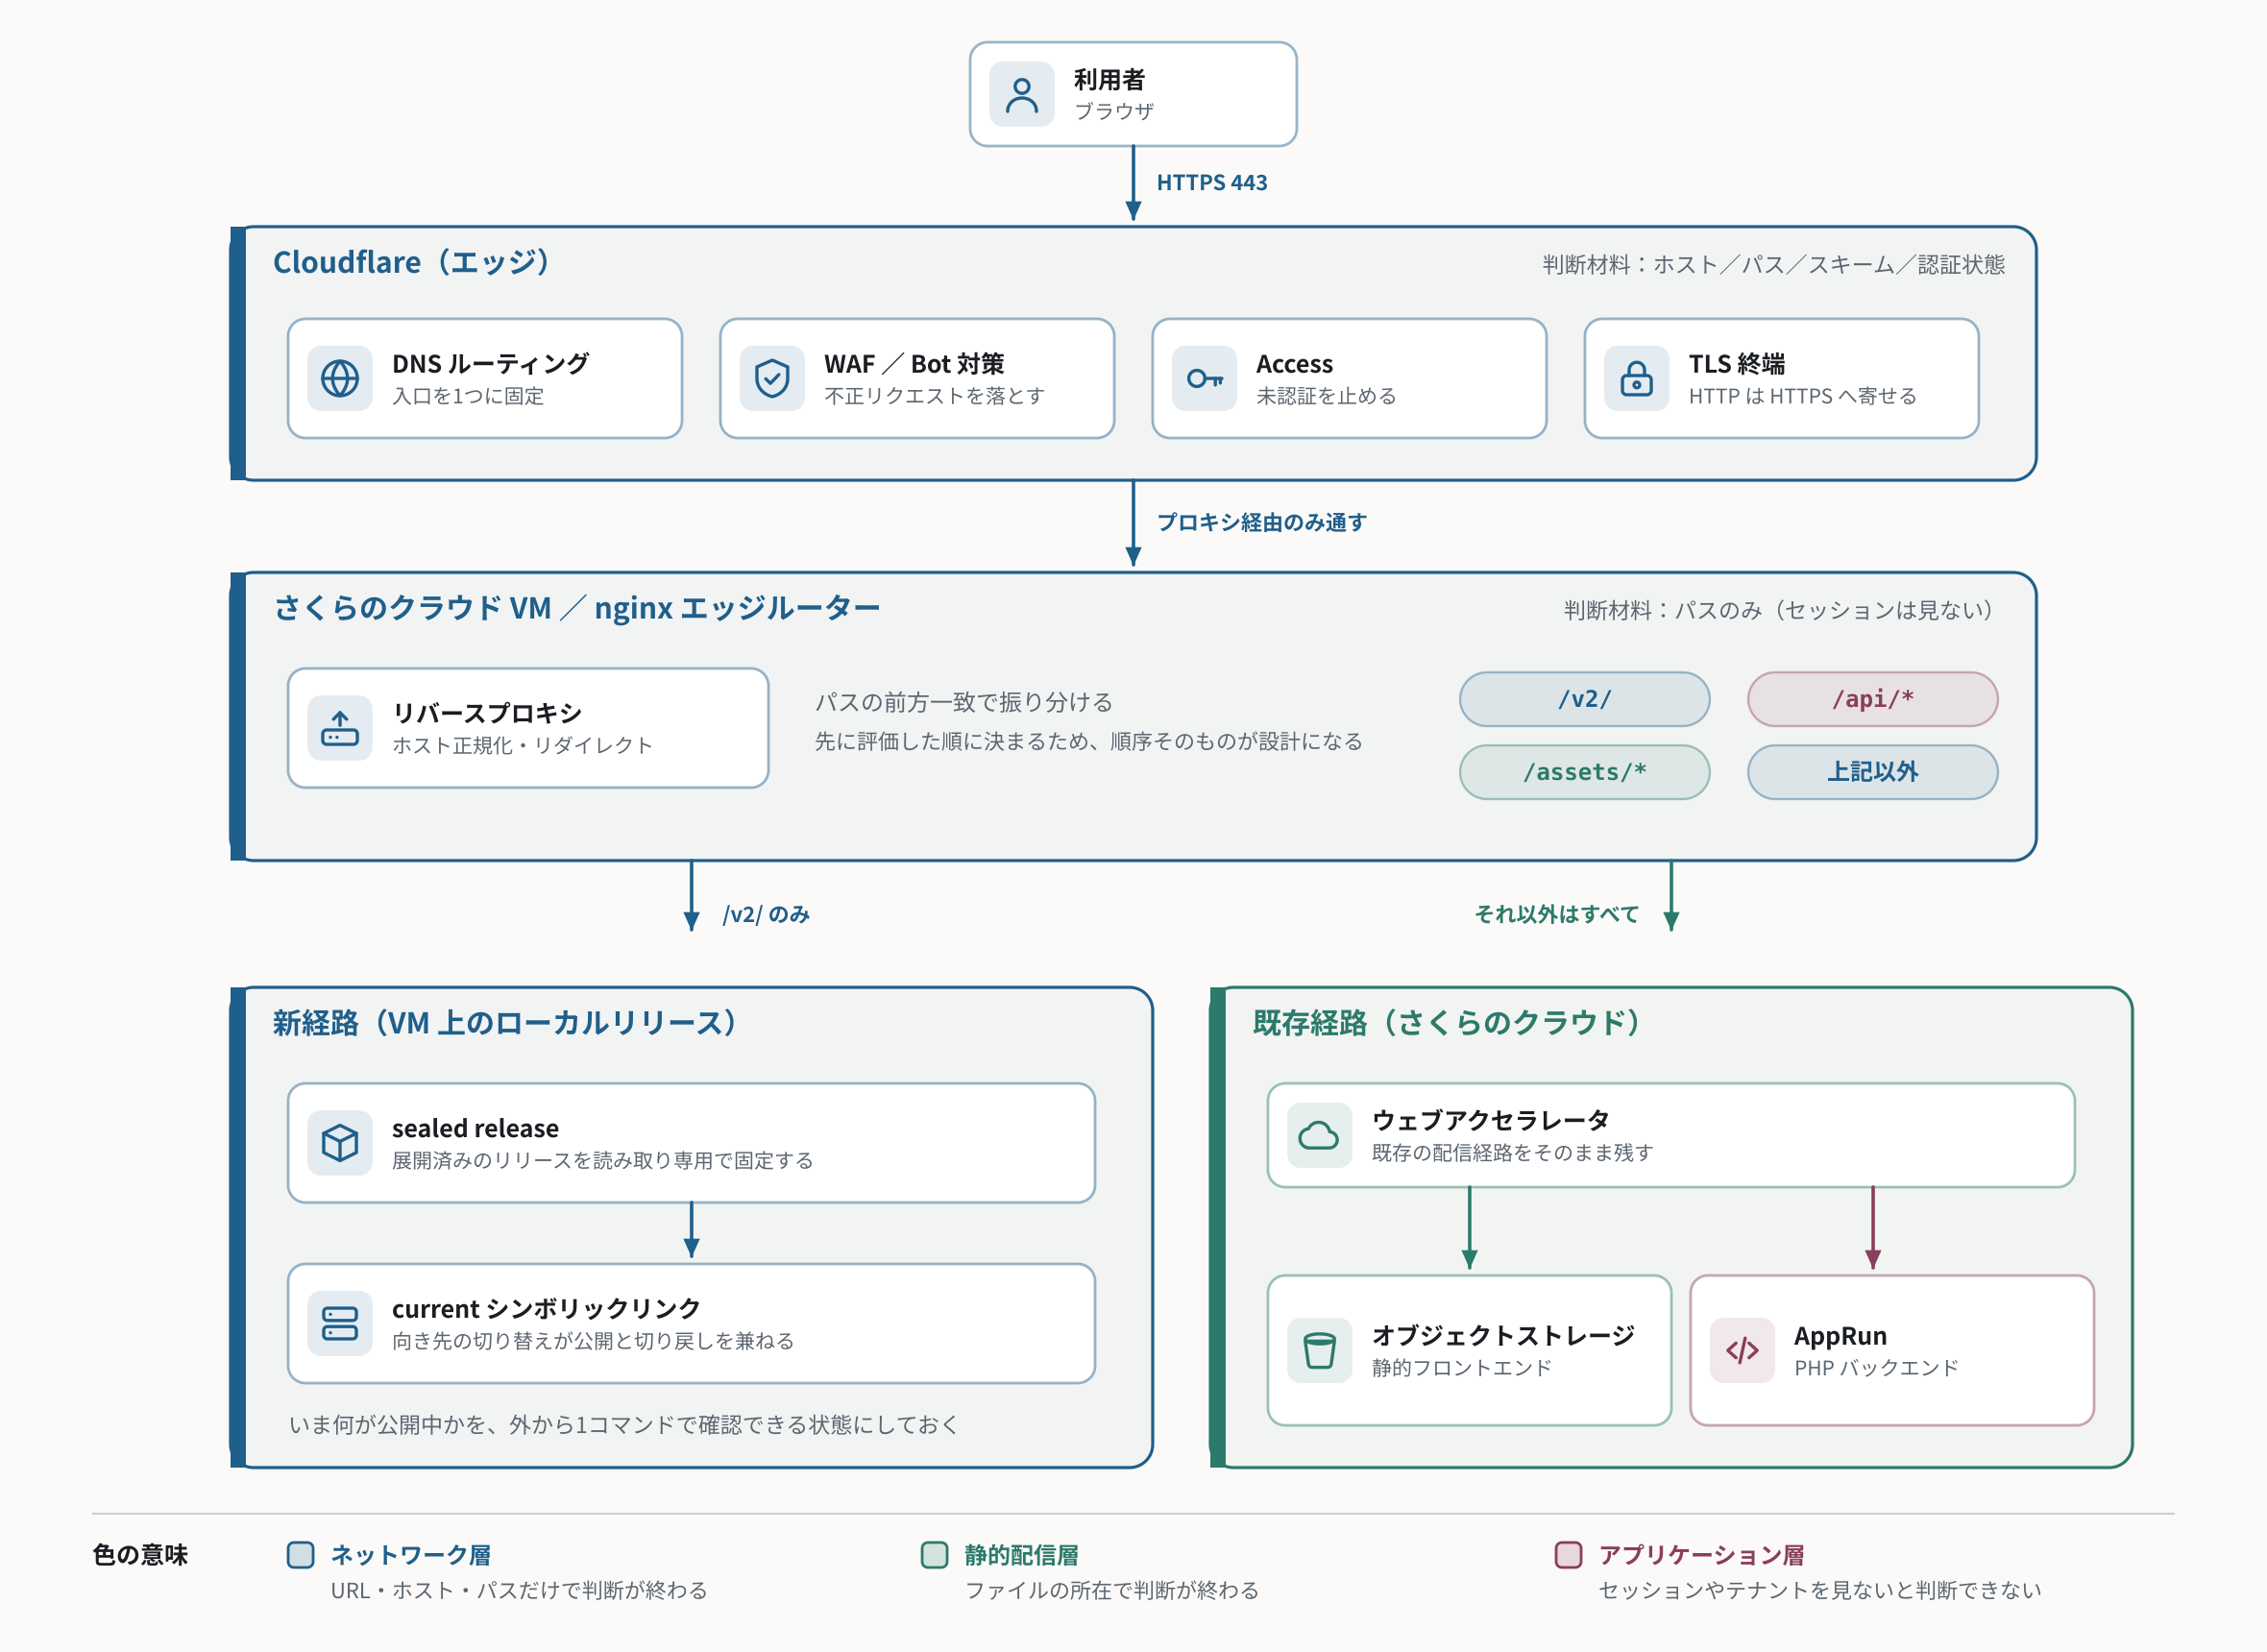

アプリ本体のロジックはほとんど触っていない。やったのは公開経路、TLS、リダイレクト、パスルーティング、リリースの切り替え、ロールバック。いわば「インフラだけのモダン化」に近い作業だった。
にもかかわらず、ハマったポイントの半分はアプリ側との境界線にあった。
「ルーティング」には少なくとも 8 種類ある
整理してみると、この構成の中で「ルーティング」と呼んでいたものはこれだけあった。
- DNS routing
- edge routing
- load balancer / reverse proxy routing
- static asset routing
- SPA routing
- API routing
- authorization routing
- provider routing
全部「どこへ流すか」を決めている。だから同じ言葉で呼びたくなる。でも判断材料がまるで違う。
特に混ざりやすいのは、次の 3 つだ。
1. URL / Host / Path だけで判断できるネットワークルーティング
リクエストラインとヘッダを見れば答えが出る。/v2/ で始まるかどうか。ホストが canonical かどうか。スキームが https かどうか。状態を持たない。
2. session / tenant / permission を見ないと判断できない業務ルーティング
「このユーザーはこの機能を使ってよいか」。同じ URL でも、誰が叩いたかで答えが変わる。DB を引かないと決まらない。
3. provider / billing / audit を伴う外部サービスルーティング
「このリクエストをどの外部プロバイダに投げるか」「クォータは残っているか」「証跡をどう残すか」。お金と監査がついてくる。
この 3 つを同じ場所で解こうとすると、必ずどこかが破綻する。逆に言うと、判断材料を見れば置くべき層は自動的に決まる。これが今回いちばん大きかった学びだった。
LB / Cloudflare / nginx 側でやるべきこと
判断材料が URL / Host / Path / スキームだけで完結するものは、全部前段に寄せる。
- ホストの正規化
- HTTP -> HTTPS リダイレクト
- canonical host へのリダイレクト
/v2/のようなパスベースルーティング- 非
/v2パスを既存 upstream へプロキシ - TLS 終端
- WAF / Access challenge
- origin への直アクセス禁止
- health check の入口整理
- static assets と API path の入口分離
パスの割り振りとしてはこういう形になる。
/v2/        -> new local release
/api/*      -> backend
/assets/*   -> static
otherwise   -> existing frontend / SPA fallback
ここに書かれている判断は、どれもリクエストを見るだけで決まる。DB もセッションも要らない。だから前段でやってよいし、前段でやったほうが速いし、設定ファイルを読めば挙動が全部わかる。
アプリ側に残すべきこと
一方、ここから先は絶対に前段に持ってこない。
- ログイン済みか
- session が有効か
- tenant はどれか
- user / role / permission は何か
- この agent / route を使ってよいか
- 外部 API へ送信してよいか
- provider をどれにするか
- quota / billing / retry をどう扱うか
- audit evidence をどう残すか
- public response に何を返すか
実際のエンドポイントで書くと、こういう連なりになる。
/api/example/invoke
  -> session check
  -> route allowlist
  -> confirmation check
  -> provider selection
  -> quota / billing
  -> external API call
  -> audit
  -> public-safe response
このパスをどこに流すかは nginx の仕事だ。でもこのパスを誰に許可するかはアプリの仕事。ここが今回の記事の主張をいちばん短く言い切った形だと思う。
ハマったところ
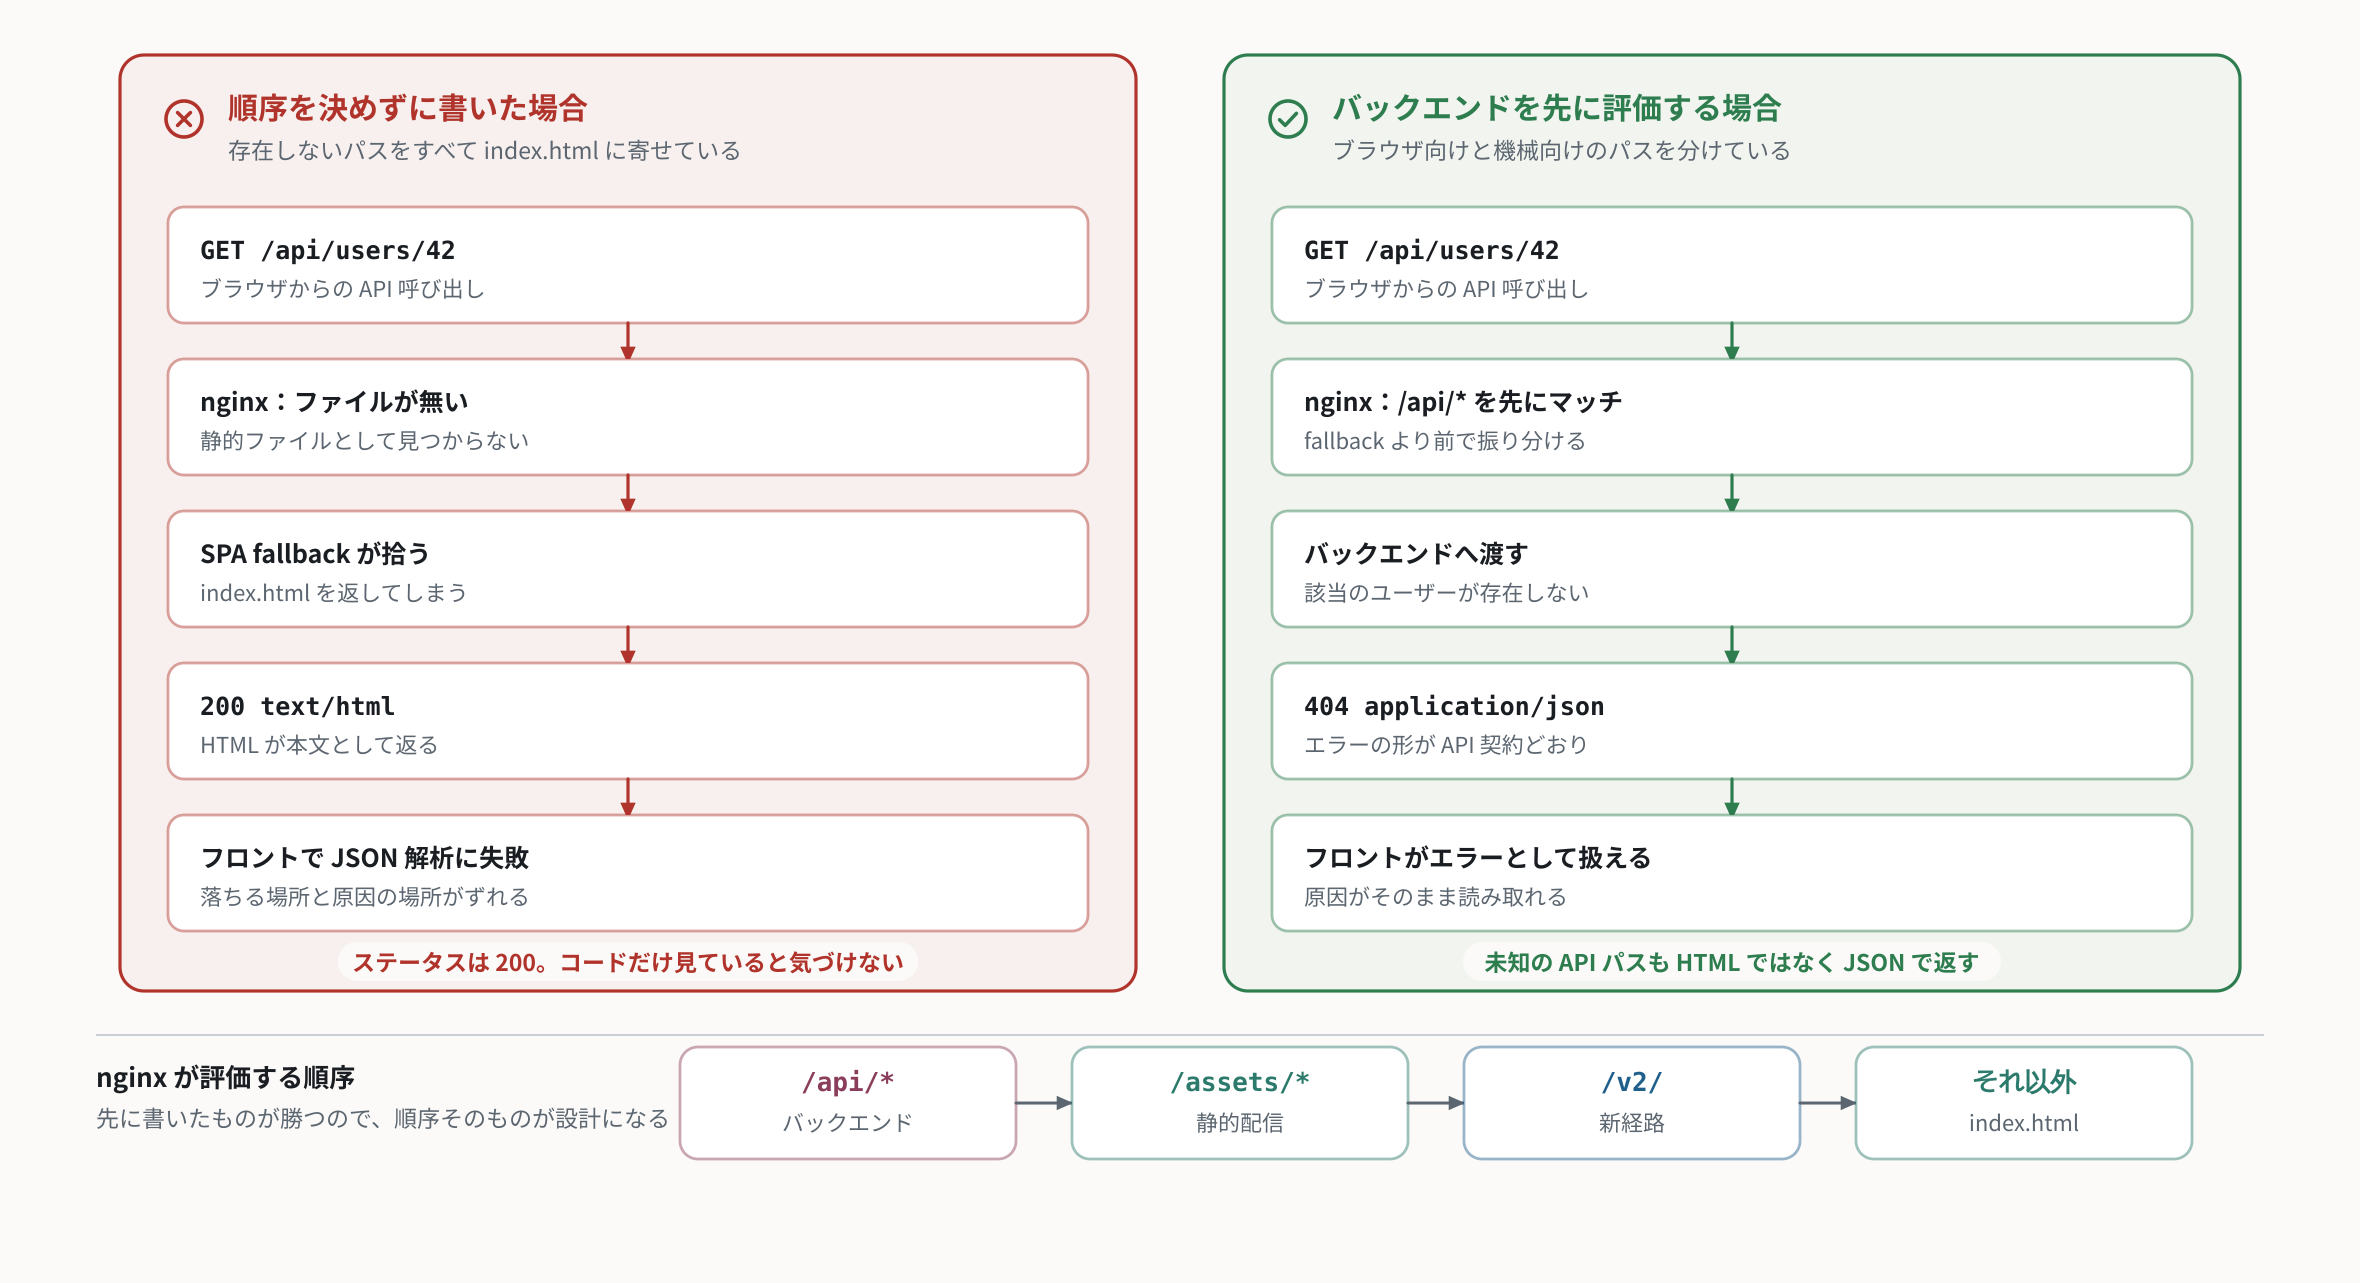
1. /api/* を SPA fallback が飲み込む
SPA では、存在しないパスを index.html に返す設定をよく書く。ブラウザ側のルーターに解釈させたいからだ。
ところがこの fallback を素朴に書くと、/api/* や /health や /ops/* まで飲み込んでしまう。すると何が起きるか。API が壊れたときに HTML が返ってくる。
curl でステータスコードだけ見ていると 200 なので気づかない。JSON をパースしようとして初めて落ちる。しかも落ちる場所がフロント側なので、原因がバックエンドにあることに気づくまで一往復余計にかかる。
教訓:
- SPA fallback の前に backend / API path を除外する
/api/*は backend に流す- 未知の API path は HTML ではなく JSON error を返す
- browser path と API path を同じルールで扱わない
ブラウザ向けのパスと機械向けのパスは、そもそも失敗の返し方が違う。混ぜてはいけない。

2. Cloudflare Access の 302 を見て安心してしまう
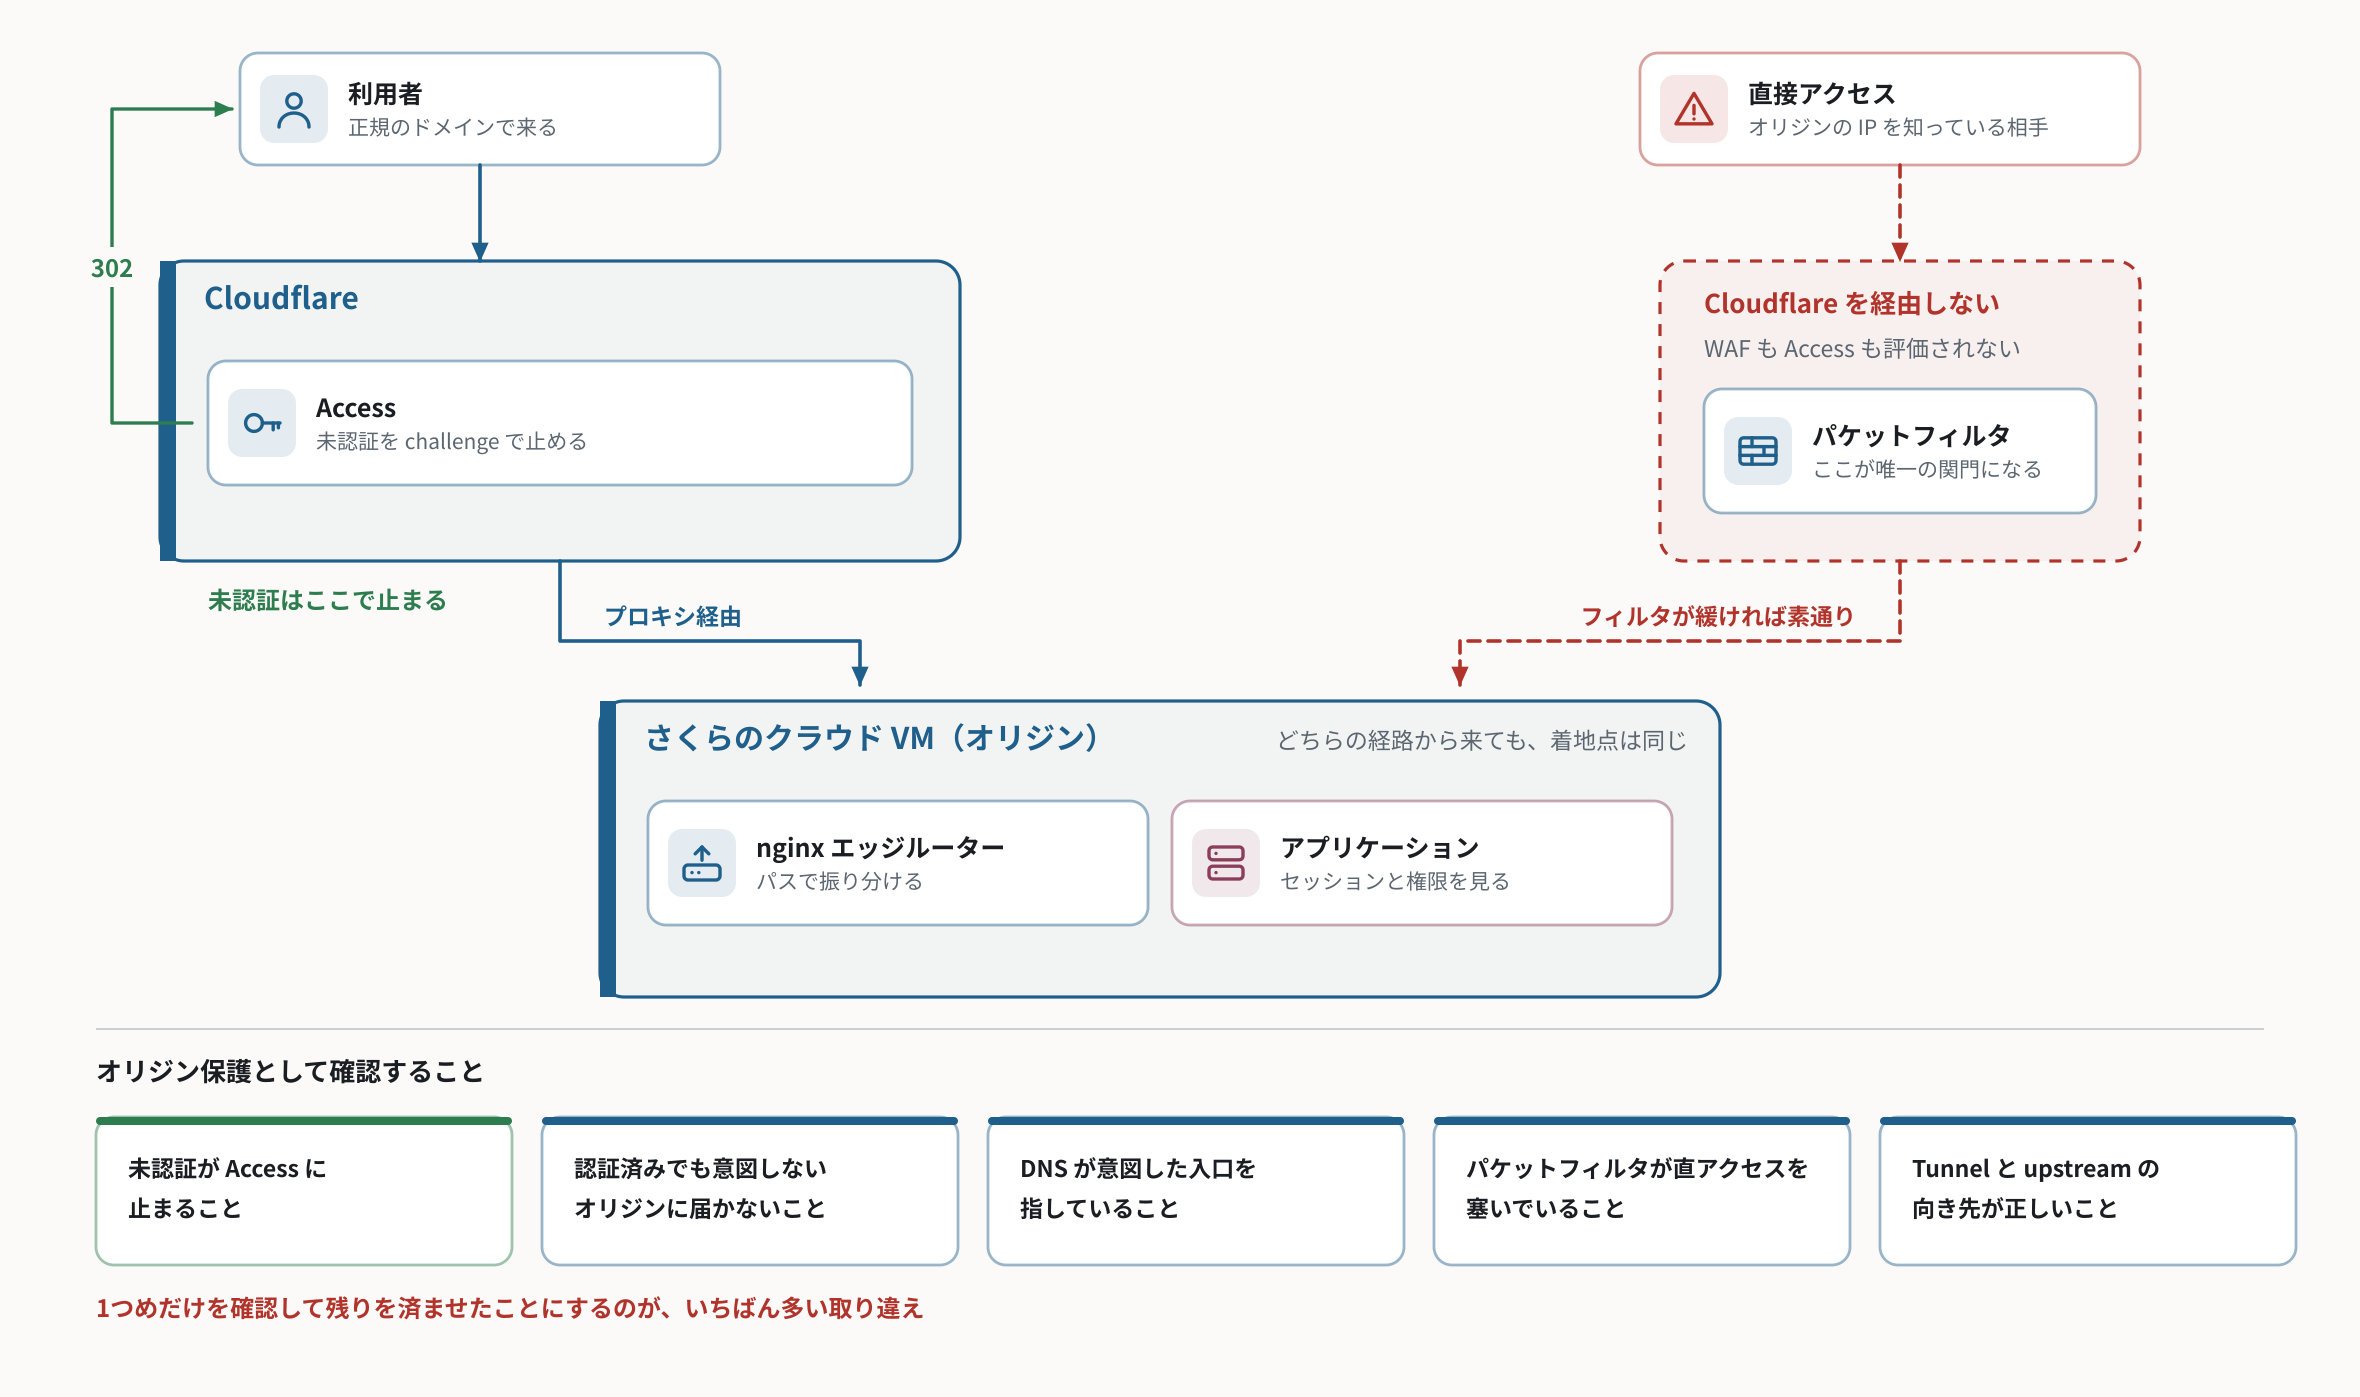
未認証でアクセスしたら Cloudflare Access の challenge が返ってきた。302 が出た。よし、守れている。
……と思ったが、これが証明しているのは「Cloudflare を通ったリクエストのうち未認証のものが止まっている」ことだけだ。origin が直接叩けないことの証明にはまったくなっていない。
Cloudflare Access の 302 は「未認証が止まった」証拠であって、「origin が守られている」証拠ではない。
実際に確認すべきなのはこのあたり。
- 未認証リクエストが Access に止められること
- 認証済みリクエストでも意図しない origin に到達しないこと
- DNS が意図した入口を指していること
- origin firewall / さくらのパケットフィルタが直アクセスを許していないこと
- Tunnel / proxy / upstream の向き先が正しいこと
前段のチャレンジ画面は「入口が動いている」ことしか教えてくれない。裏口が空いているかどうかは、裏口側から確かめるしかない。

3. /health が内部情報をしゃべりすぎる
LB のヘルスチェックや監視のために /health を生やすのは便利だ。便利なので、デバッグ中にどんどん情報を足したくなる。
気づいたら、レスポンスに provider の endpoint、モデル名、quota の設定値、内部モード、feature flag が並んでいた。認証なしで見えるところに。
便利なエンドポイントほど、内部構成をしゃべりすぎる。
教訓:
- public health は最小限にする
status: okと、公開してよい依存先のステータスくらいに絞る- 詳細診断は認証済みの admin / ops / 内部ログに寄せる
- provider endpoint やモデル名は public health に出さない
デバッグ用に足した情報は、デバッグが終わったら消す。あるいは最初から認証済みの別エンドポイントに置く。
4. path routing と認可 routing を同じ場所で解こうとする
/v2/ をどこに流すかは nginx で判断できる。設定ファイルに 3 行書けば終わる。
でも「このユーザーがこの機能を使ってよいか」は nginx では判断できない。判断材料がリクエストの中にないからだ。session を引いて、tenant を特定して、role を見て、はじめて答えが出る。
ここを無理に前段でやろうとすると、LB に認証情報を渡す仕組みを作ることになり、その仕組み自体が新しい攻撃面になる。
教訓:
- path だけで判断できるならインフラ
- user / session / tenant が必要ならアプリ
- provider / cost / audit が必要ならアプリ
- ルーティングの判断材料を見れば、置くべき層が決まる
ロードバランサーで解ける問題と、ロードバランサーで解いてはいけない問題がある。
5. 既存経路と新経路の境界が曖昧になる
一部のパスだけを新経路に寄せると、既存の WebAccel / AppRun / オブジェクトストレージと、新しい nginx edge が並存する期間ができる。
この状態で「どちらが正本か」「fallback 先はどこか」「ロールバックはどこでやるか」を決めていないと、障害時に人間が迷う。片方を直したつもりで、もう片方が生きていた、みたいなことが起きる。
教訓:
- 新経路の責務をパス単位で明文化する
- 既存 upstream へのプロキシは「意図してそうしている」と明示する
- ロールバック先を先に用意する
- release symlink / sealed release のように、いま何が active かを外から検証できる形にする
「たぶんこっちが動いている」で運用しないこと。
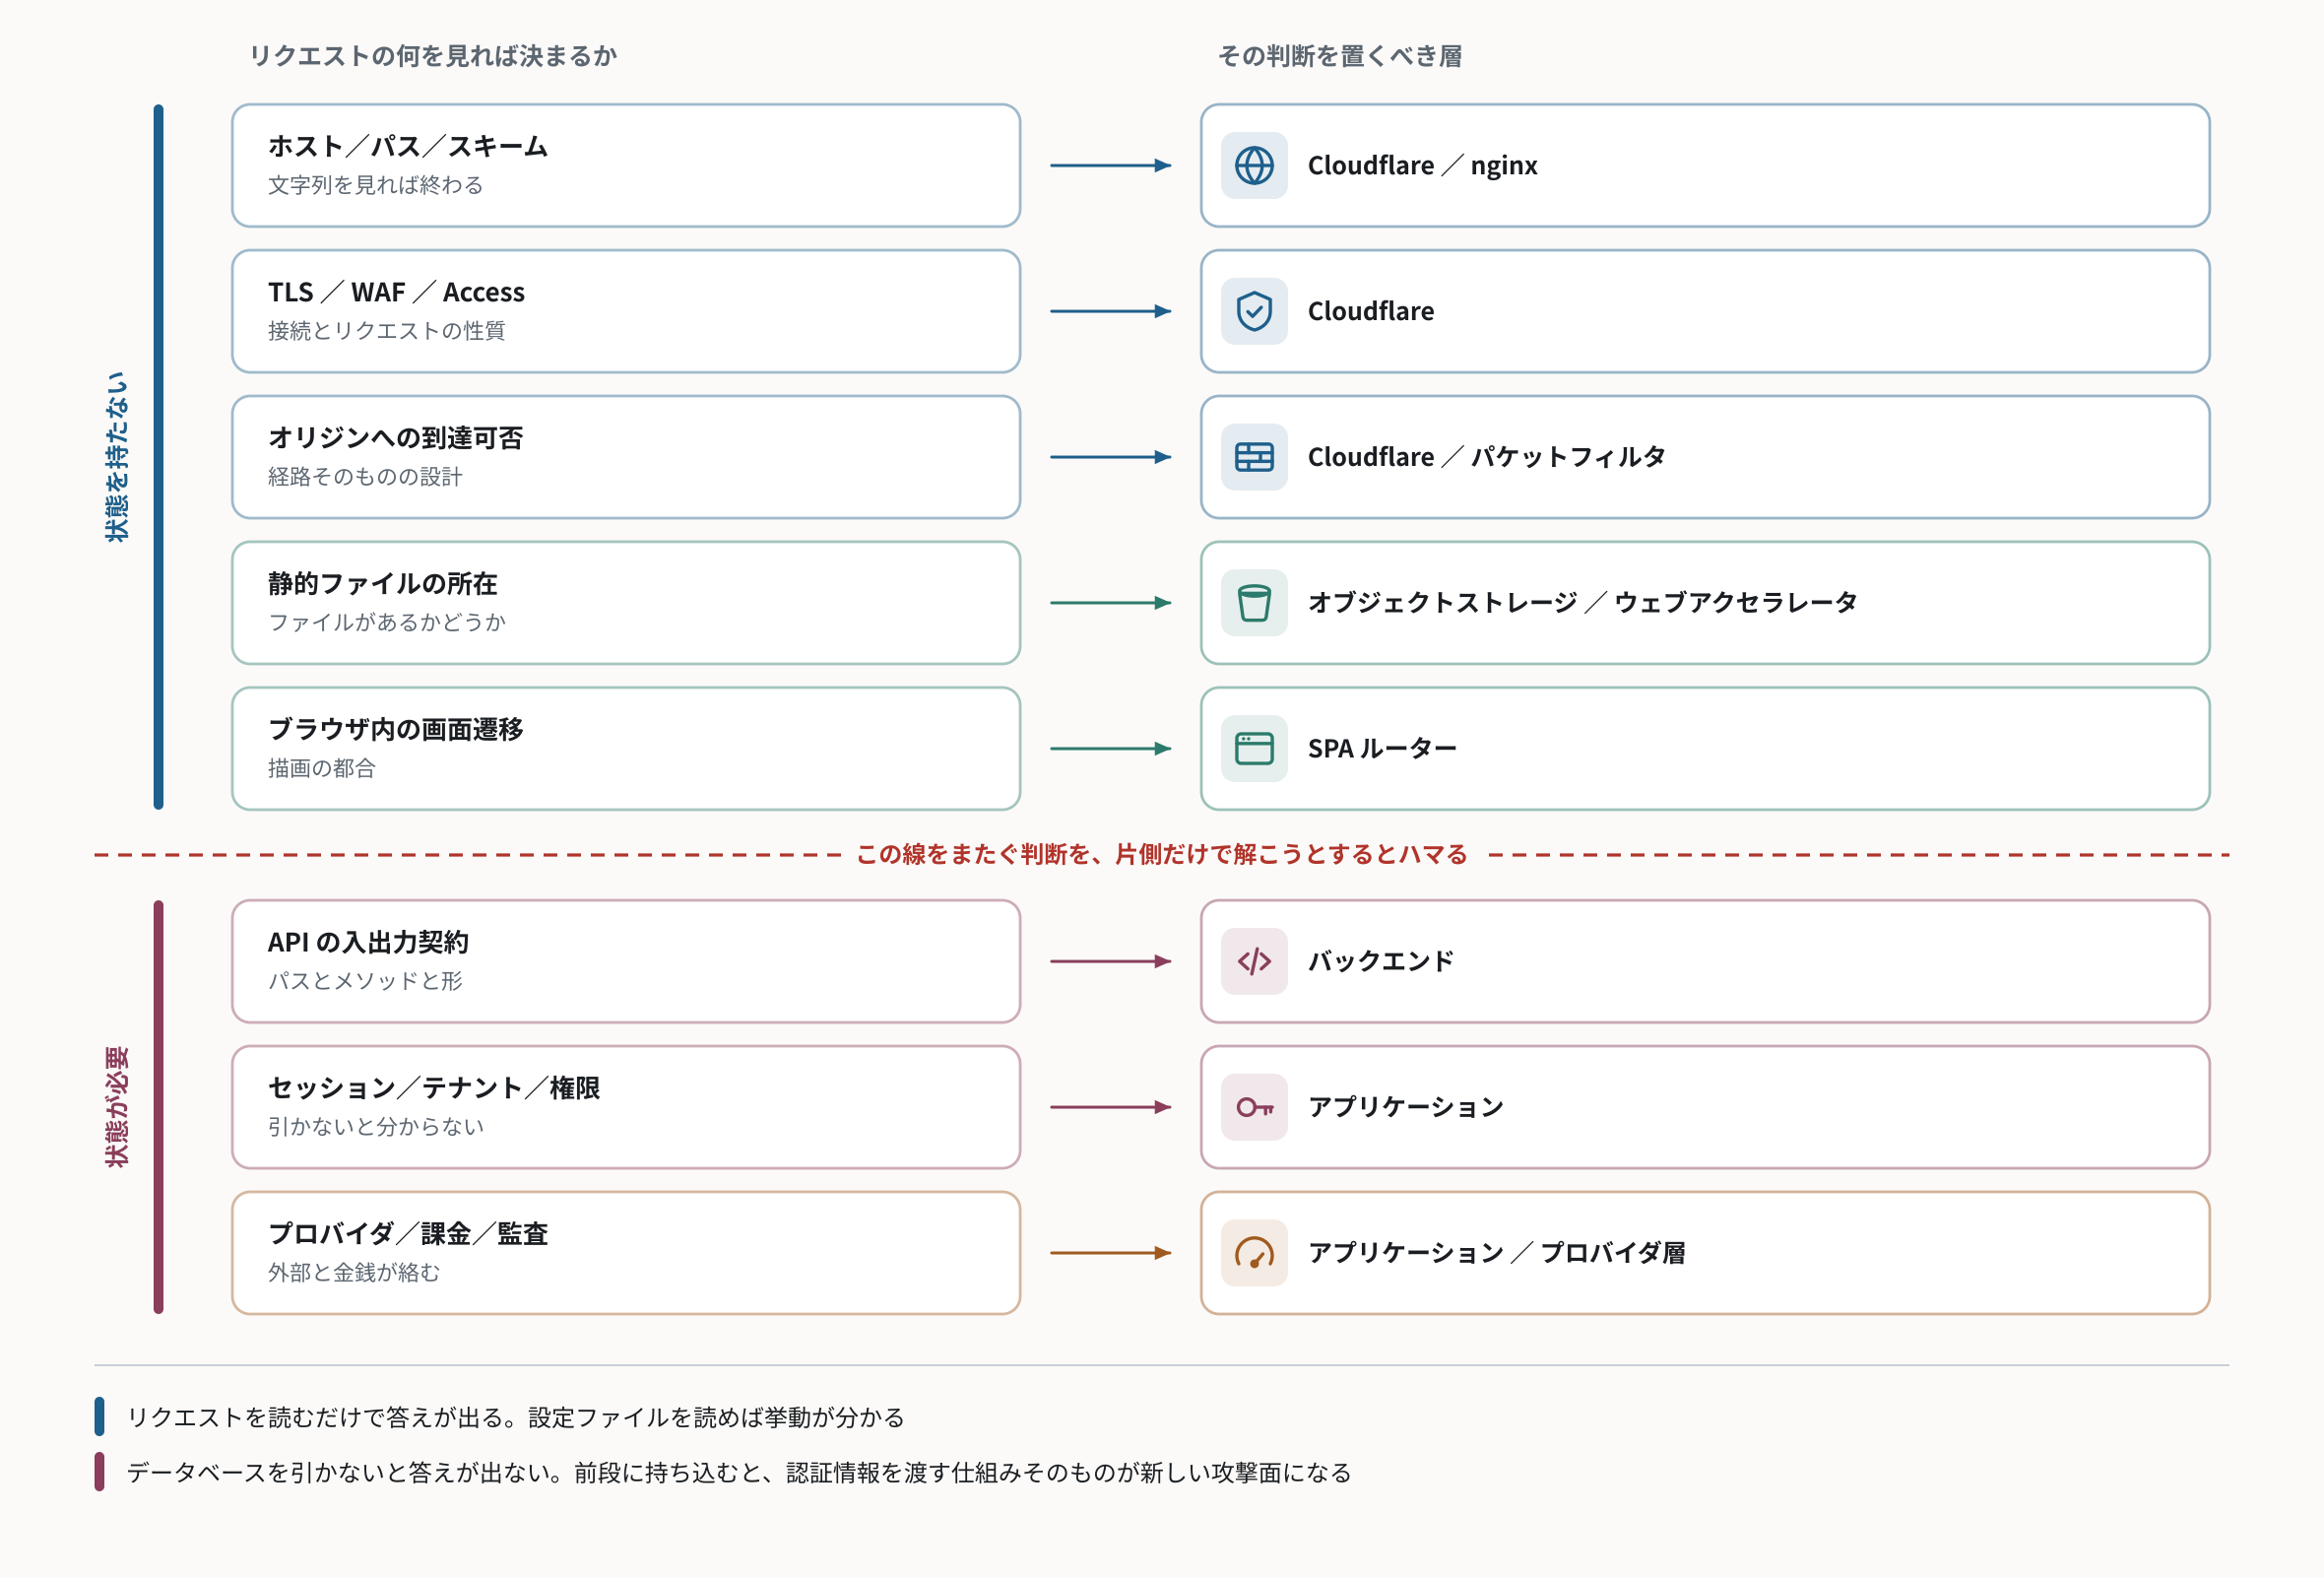
判断基準の表
最終的に、こういう表に落ち着いた。迷ったらここに戻る。
| 判断材料 | 置くべき層 |
|---|---|
| Host / path / scheme だけ | Cloudflare / LB / nginx |
| TLS / WAF / Access | Cloudflare |
| origin 到達性 / firewall | Cloudflare / さくらのクラウド / packet filter |
| static file path | Object Storage / WebAccel |
| ブラウザの画面遷移 | SPA router |
| API contract | Backend |
| session / tenant / permission | Application |
| provider / quota / billing / audit | Application / provider layer |
左の列を見れば右の列が決まる。逆に、右をどこにするか迷っているときは、左が曖昧になっている。

検証は 3 つに分ける
もうひとつ、作業中に効いた分け方がある。「動作確認」をひとまとめにしないこと。
「通った」「守れている」「業務的に正しい」は別々に検証する。
- 通った — リクエストが意図した経路を通り、意図したステータスとコンテンツタイプが返ってくる。curl とステータスコードの世界。
- 守れている — 未認証が止まる。origin に直接届かない。public に出してはいけない情報が出ていない。回避経路がない、という否定形の確認。
- 業務的に正しい — 正しい tenant のデータが返る。権限のないユーザーが弾かれる。課金と監査ログが期待どおり残る。
この 3 つは通る道が違うので、ひとつ確認したからといって他が保証されることはない。1 番目だけ見て終わりにしたときに、2 番目の抜けに気づかなかったのが今回の反省点だった。
チェックリスト
同じ構成を触る人向けに、最後にチェックリストを置いておく。
/api/*は SPA fallback より前に backend へ流しているか- 未知の API path は HTML ではなく JSON error を返すか
- public health に内部 endpoint / モデル名 / secret に近い設定を出していないか
- Cloudflare Access の未認証 challenge だけで origin protection 完了扱いにしていないか
- 認証済みパスでも意図しない origin に到達しないことを確認したか
- origin firewall / パケットフィルタは直アクセスを塞いでいるか
- path routing と session / tenant / permission 判定を混ぜていないか
- provider / billing / audit の判断を LB に押し込んでいないか
- 既存経路と新経路の責務境界をドキュメントに書いているか
- ロールバック先と、いま何が active かの検証方法があるか
おわりに
「ルーティングを直す」という一文には、ネットワークの話と業務の話と外部サービスの話が全部詰まっていた。詰まったまま考えていたから、議論も検証も毎回とっちらかっていた。
レイヤーごとに分解して、判断材料で置き場所を決める。それだけで、設定ファイルを読めばわかることと、コードを読まないとわからないことが、きれいに分かれた。
ルーティングは一枚岩ではない。分解して、それぞれの責務を決める。それだけの話だけれど、決めるまでは毎回ふりだしに戻っていた。
よくある質問
Q1. SPA を配信すると /api/* が HTML を返してしまうのはなぜか
SPA の deep link 対応として、存在しないパスを index.html に返す fallback を設定しているからだ。この設定はブラウザ向けのパスには正しく働くが、除外指定をしないと /api/* や /health のような機械向けのパスまで飲み込んでしまう。結果として、API が 404 を返すべき場面で 200 と HTML が返り、フロント側の JSON パースエラーとして表面化する。fallback を書く前に backend / API のパスを先にマッチさせ、未知の API パスは JSON のエラーとして返すのが正解になる。
Q2. Cloudflare Access を有効にすれば origin は守られたことになるのか
ならない。未認証アクセスで challenge や 302 が返ることが証明しているのは、Cloudflare を経由したリクエストのうち未認証のものが止まっている、という事実だけだ。origin の IP が直接叩ける状態であれば、その経路は Access をまったく通らない。DNS の向き先、origin firewall やさくらのクラウドのパケットフィルタ、Tunnel / upstream の設定を、前段とは別に確認する必要がある。
Q3. /health エンドポイントには何を書いてよいのか
公開する health には status: ok と、外部に見せて問題のない依存先のステータス程度に絞るのが安全だ。provider の endpoint、モデル名、quota の設定値、内部モード、feature flag といった情報は、監視には不要である一方で、攻撃者にとっては構成の地図になる。詳細な診断情報が必要なら、認証済みの admin / ops エンドポイントか内部ログに寄せる。デバッグ中に足したフィールドが公開のまま残っていないかは、リリース前に一度見直しておきたい。
Q4. 認可の判断を Cloudflare や nginx に寄せてはいけないのか
判断材料で決まる。ホスト、パス、スキームだけで答えが出るなら前段でよいし、そのほうが速く、設定を読めば挙動もわかる。しかし「このユーザーがこの機能を使ってよいか」は session を引き、tenant を特定し、role を見なければ決まらない。この判断を無理に前段へ持ち込むと、LB に認証情報を渡す仕組みを別途作ることになり、その仕組み自体が新しい攻撃面になる。
Q5. さくらのクラウドの WebAccel と自前の nginx は併用してよいのか
併用自体は問題ない。実際、一部のパスだけを新しい経路に寄せ、それ以外は既存の WebAccel へプロキシする構成は現実的な移行手段になる。ただし、パス単位で「どちらが正本か」を明文化しておかないと、障害時に片方だけ直して終わったつもりになる事故が起きる。既存 upstream へのプロキシは、暗黙の残骸ではなく意図した設計としてドキュメントに残しておくとよい。
Q6. 段階的な経路移行では、何を決めてから切り替えるべきか
最低限、パスごとの責務境界、fallback 先、ロールバック手順、そして「いま何が active か」の検証方法の 4 つだ。とくに最後が抜けやすい。release symlink や sealed release のように、外から一発で現行リリースを確認できる形にしておくと、切り戻しの判断が速くなる。逆にこれがないと、「たぶんこっちが動いている」という前提で復旧作業を始めることになる。
